

先选择接入线路
- 官转即官方 API 转发,令牌分组选
Sora2Official或GPTImage2 Sora2 Enterprise,计费模式选「按量优先」或「按量计费」,单价与gpt-image-2官转相同,见官转计费。 - VIP 与网页版的令牌计费模式选「按量优先」或「按次计费」;其他图像分组的名称见控制台。
- 三条线路都用
/v1/images/generations生成、/v1/images/edits编辑。已有 GPT Image 2 集成可继续参考 GPT Image 2 文档。
价格与能力一览
价格为 2026 年 9 月 24 日公开价格配置,核对日期 2026 年 10 月 14 日,见模型与价格总表。VIP 与网页版的尺寸、五档质量都不改变单价,生成与编辑同价。模型来自 OpenAI 官方渠道:官转按 OpenAI 官方 token 价计费,按次线路以固定单价计费,高分辨率和高质量档位时低于按 token 计费。各质量档位的单张成本
两条线路调用的是同一个模型,同一个请求消耗的 tokens 相同,差别只在计费方式。下表的 tokens 来自本页生成示例在老张API上的实测(1024×1024,2026 年 9 月 9 日与 10 月 14 日):- 官转每张 = 图片输出 tokens ×
Sora2Official分组每 1M $30;文字和参考图输入另计,GPTImage2 Sora2 Enterprise分组再加 20%。 - VIP 单价不随尺寸、质量、参考图数量和生成 / 编辑变化。
high及以上档位,VIP 的单张成本更低。
VIP 文生图示例的输出:Flare VIP,2048×2048,medium
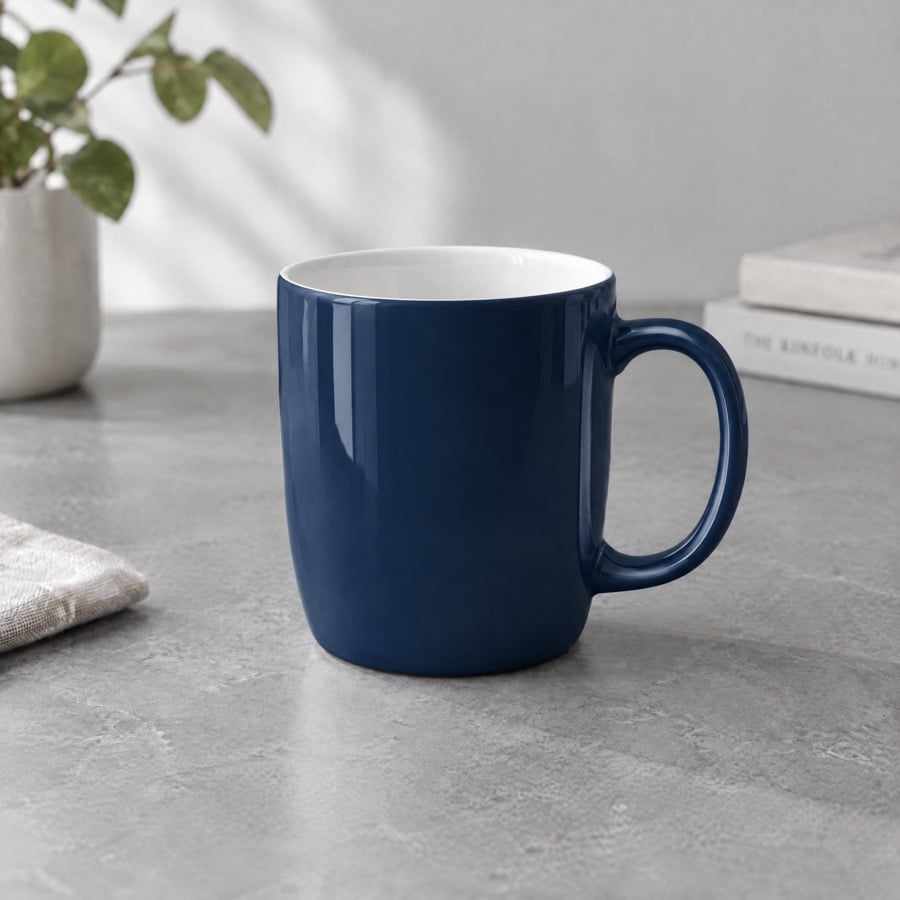
VIP 图像编辑示例:Sunburst VIP 只把杯身改为深蓝色
官转模型与分组
一般接入使用不带日期的别名;需要固定版本时,使用表中的完整快照 ID。别名的当前映射今后可能变化。
- 在令牌管理创建令牌,计费模式选择「按量优先」(推荐)或「按量计费」,并确认令牌允许调用目标模型。
- 分组选择官转分组,分组只在创建令牌时选择,不填入请求的
model:Sora2Official:与 OpenAI 官方同价,上游为 Azure OpenAI 与 OpenAI 官方密钥混合。GPTImage2 Sora2 Enterprise(企业官转):只使用 OpenAI 官方密钥,为官方价加 20%,适合优先稳定性的生产调用。
- 保留原有官转 Images API 的鉴权、请求结构和结果处理,只把
model改为上述别名或快照 ID。
官转最小接入
以下示例分别调用官转的文生图和图像编辑接口,在 SDK 中对应images.generate 与 images.edit。先设置官转令牌,并安装保存脚本需要的 pillow:
Flare 文生图
Sunburst 图像编辑
先准备本地source.png,再运行:
保存图片与查看结果
响应的data[] 中,每一项是下面两种之一:
b64_json:Base64 图片内容,可能带data:image/png;base64,这类前缀,也可能缺少末尾的=。url:图片下载地址,会过期,收到响应后要尽快下载。
save_images.py,它会处理上述情况,并按实际格式命名文件:
官转计费
两款官转模型按量计费,与gpt-image-2 官转的 token 单价相同,按文本输入、图片输入和图片输出的实际用量扣费。2026 年 9 月 24 日公开价格配置中,Sora2Official 分组的单价如下,与 OpenAI 官方价格相同:
GPTImage2 Sora2 Enterprise 分组在此基础上加 20%(分组倍率 1.2),例如图片输出为每 1M tokens $36。当前价格以模型与价格总表和控制台为准,企业报价联系支持团队确认。
token 单价相同不等于每张图片的总价相同:模型、尺寸、质量和参考图都会影响 token 用量,应以代表性请求的 usage 估算。token 的计算方式见 OpenAI 图像生成指南的成本说明。
VIP 按次计费接入
两款 VIP 模型按次计费,接入方式与gpt-image-2-vip 相同:使用 default(默认分组)或其他图像分组(名称见控制台)中计费模式为「按量优先」(推荐)或「按次计费」的令牌。
调用时必须保留模型名中的 -vip 后缀;不带后缀的 Flare / Sunburst 走官转,按 token 计费。本节的参数和示例只适用于这两款 -vip 模型,不能直接套用到 gpt-image-2.5-web。
两款 VIP 模型曾于 2026 年 9 月 16 日停用,9 月 22 日起恢复可用,见恢复公告与调用说明。
尺寸与质量
两款 VIP 模型的文生图请求都可以使用size 和 quality。不需要指定尺寸或质量时,省略相应字段即可。
常规尺寸覆盖 1K、2K、4K 及常见的方图、横图和竖图画幅,也可以使用合法范围内的自定义宽高,例如
1440x960、1536x864 或 2048x1152。自定义尺寸需同时满足:
- 宽、高均为 16 的整数倍;
- 任一边不超过 3840 像素;
- 长边与短边之比不超过 3:1;
- 总像素数(宽 × 高)在 655,360 到 8,294,400 之间。
size。
下表是常用尺寸示例,不是完整列表:
不符合上述条件的尺寸可能被自动调整,例如
1023x1024 可能返回 1024x1024。需要精确像素时,使用符合条件的尺寸,并检查返回图片的实际宽高。
入门请求可以先用 size="2048x2048"、quality="medium"。
2026 年 9 月 9 日与 10 月 14 日实测的单次 1024×1024 请求耗时:medium 约 20–70 秒,high 23–49 秒,xhigh 46–77 秒,max 73–156 秒,同档位 Sunburst 比 Flare 慢。客户端超时至少设 300 秒,超时后先查调用日志再决定是否重试。
文生图示例
已有gpt-image-2-vip 集成时,保留 base URL、鉴权、接口和结果处理,把 model 换成完整的 -vip 模型 ID。以下示例生成一张 2K 方图:
图像编辑示例
编辑使用/v1/images/edits 和 multipart 请求。先准备本地 source.png,上传图片并描述需要修改的内容:
save_images.py 保存。
透明背景 PNG
两款 VIP 模型都支持生成透明背景 PNG,也支持上传图片后去除背景、保留主体。在请求中设置:1024x1024 和 medium。
生成透明背景图片
上传图片并去除背景
先准备本地source.png,再上传原图并描述需要保留的主体:
save_images.py 保存后得到 PNG 文件,alpha 通道保留透明区域,可以直接叠放到其他底色上。不要转存为 JPEG,否则会丢失透明效果。示例和我们的核对都用 1024×1024;换用其他尺寸时,先用少量请求确认输出带 alpha 通道。
透明背景与
mask 局部编辑是不同功能。这两款按次模型不支持通过 mask 限定修改区域;去背景时使用上面的 background="transparent" 参数和保留主体的提示词即可。网页版线路
网页版 2.5 的模型 ID 是gpt-image-2.5-web,这条线路:
- 按次计费;
- 支持生成(
/v1/images/generations)和编辑(/v1/images/edits),支持size; - 不能指定 Flare / Sunburst,参数以控制台和调用结果为准。
-vip 模型,各线路的尺寸与质量参数见上文。
gpt-image-2-web 是已有集成使用的历史网页版 ID,与 gpt-image-2.5-web 不是同一路由,参数也不能混用。当前令牌权限和实际输出以控制台及调用结果为准。
常见问题
不用 OpenAI 账号能调用 GPT Image 2.5 吗?
可以。只需要老张API密钥,不需要 OpenAI 账号。三条线路都走 OpenAI 兼容的 Images 接口,已有 OpenAI SDK 代码只需改base_url 和密钥。
Flare 和 Sunburst 同价吗?怎么选?
价格相同:官转的两款模型使用同一组 token 单价(见官转计费),两款-vip 模型的单次价格也一样。选择只看效果:日常生成、在意出图速度选 Flare,改图时更看重保留原图细节选 Sunburst。两款都能生成和编辑,也可以都提供给用户挑选。
2026 年 10 月 14 日用本页示例提示词、max 档各生成一张,两款都消耗 7,024 输出 tokens,Flare 用时 80 秒,Sunburst 153 秒:
Flare VIP,1024×1024,max:80 秒
Sunburst VIP,1024×1024,max:153 秒
VIP 和官转哪个更省?
看质量档位,见各质量档位的单张成本。1024×1024 时,low 和 medium 官转更省;high 及以上 VIP 更省,因为按 token 计费的一张图已经超过 $0.05。输出 2K、4K 或带参考图编辑时,VIP 仍是 $0.03。
编辑或带参考图会加价吗?
VIP 不加价:带一张或多张image[] 参考图的编辑都是一次 $0.03。官转的参考图按图片输入 tokens 计费,每 1M $8,在输出 tokens 之外另计,所以同档位的编辑比生成贵。
换到 2.5 后 quality 能照旧填吗?
可以照旧填low、medium、high,但同名档位在两代模型上消耗的输出 token 可能不一样。按 OpenAI 的说明,两代模型的图片输出 token 单价相同,同一质量设置用到的 token 数却可能不同。
所以从 gpt-image-2 换过来后,要用自己的提示词重新测官转的费用和耗时,对照响应里的 usage 或调用日志。
2.5 还新增了 xhigh 和 max 两档,上一代最高只到 high。VIP 模型按次计费,五档价格相同,档位只影响细节和耗时。
官转一张图多少钱?为何扣费不同?
官转没有固定的单张价格,费用按实际 token 用量计算,单价见官转计费。 参数一样、扣费却不同,最常见的原因是quality 没有传或传了 auto:这时由模型根据生成内容自行选档,同一个请求两次落在不同档位,输出 token 和费用就不同。
需要稳定预算时,显式传 size 和 quality,再用几次代表性请求的 usage 估算单张成本。实际扣费以调用日志为准。
请求失败或超时会扣费吗?
上游返回非 200 的请求不扣费,例如参数错误、内容审核拦截、鉴权失败和限流。请求进入生成并返回图片后,官转按实际 token 扣费,-vip 与网页版按次扣费。
客户端超时或主动断开并不会取消服务端的生成,生成完成后照常扣费。高分辨率和高质量档位耗时更长,客户端超时要留足;超时后先在调用日志确认上一次请求的状态,再决定是否重试,避免重复生成和重复扣费。实际扣费以调用日志为准。
response_format 为何报错?
官转按 OpenAI 的规则返回 Base64 图片,不支持 DALL·E 时代的response_format 参数,传了可能直接返回参数错误,删掉即可。需要图片链接时,把 b64_json 解码后上传到自己的对象存储。
按次模型(-vip)可以用 response_format 指定返回形式:
b64_json:只返回 Base64 图片,在data[0].b64_json。url:返回图片链接。链接有有效期,拿到后尽快下载并转存到自己的存储。- 不传:通常返回 Base64,偶尔返回链接。代码只读取
b64_json时,请显式传b64_json。
save_images.py 两种字段都能保存,见保存图片与查看结果。
编辑能传多张参考图或用 mask 吗?
官转可以,规则与 OpenAI 相同:- 一次最多 16 张参考图,multipart 请求中重复传
image[]字段;参考图按图片输入 tokens 计费,张数越多,输入费用越高。 mask只作用于第一张图,需要与这张图格式、尺寸相同,带 alpha 通道;mask 用 PNG,小于 4MB,原图小于 50MB。- mask 只是引导,模型不一定严格沿着 mask 的边缘修改,上线前先用少量请求确认效果。
-vip 模型可以重复传 image[] 一次提交多张参考图,但不支持 mask,传了也不能可靠地只改指定区域。只想去掉背景时,用透明背景 PNG 中的参数和提示词。
编辑能直接传图片 URL 吗?
不能。/v1/images/edits 只接受 multipart 上传的图片文件;用 JSON 传 image_url,或把 URL 写进表单字段,都会返回错误。图片在 CDN 上时,先下载到本地再上传:
- 整个请求不要超过 20MB;大照片先缩小或转成 JPEG 再上传,文件越大,上传和处理越慢。
- multipart 直接传文件的二进制内容,比同一张图的 Base64 小约四分之一。