

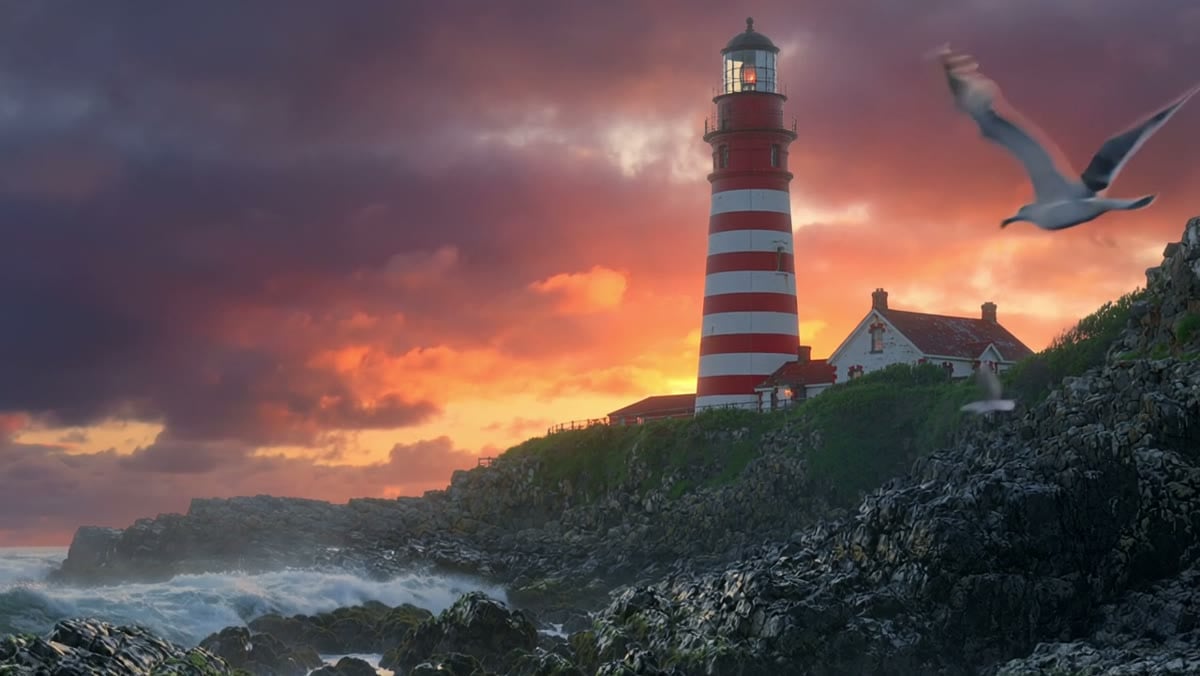
下のテキストから動画を生成する例の出力:muse-video、10秒、16:9(プロンプトは出力例に対応するため英語のままです)
料金と選び方
料金
Museの動画は、1本ごとの課金です。モデル内で選ぶ長さ、アスペクト比、画像を送るかどうかで料金は変わりません。
課金のルールです。
- タスクの作成時に課金され、失敗したタスクは全額返金されます。
- パラメーターエラーで送信時に拒否されたリクエストは、課金されません。
- 再送するたびに新しいタスクが作成され、再び課金されます。自社のジョブIDとタスクの
idの対応を保存してください。
動画モデルの選び方
2026年10月31日時点で、720p以上の10秒クリップでは、MuseがLaoZhang APIで最も低価格です。動画1本あたりの定額料金、20〜60秒の連続した1本のクリップが必要なときに使ってください。 2K、参照動画、参照音声が必要なときは、MiniMax H3を使います。1080pが必要なときや、人物にセリフを話させたいときは、Gemini Omni 1.2 Flashを使ってください。各モデルで5秒・10秒のクリップがいくらか、どのエンドポイントを使うかは、動画APIの比較にまとめています。出力例
次のクリップは、編集していないMuseの出力で、モデルが生成した音声がそのまま付いています。クリックすると再生されます。キャプションには、モデル、長さ、アスペクト比、プロンプトを載せています。 MiniMax H3の出力例は同じプロンプトを使っているため、2つのモデルをシーンごとに比較できます。muse-video、5秒、16:9。プロンプト:A red fox walking through snowy forest at sunrise, cinematic
muse-video-20s、20秒、16:9。プロンプト:A paper boat drifts down a rainy city gutter, then sails into a small sunny pond
muse-video-40s、40秒、16:9。プロンプト:A hot air balloon rises over a valley at dawn, drifts over a river and a village, then lands in a meadow
muse-video-50s、50秒、9:16の縦向き。プロンプト:A cyclist rides through a coastal town from morning to sunset: market, harbor, cliff road, lighthouse
始める前に
トークンの作成
トークン管理で、次の設定でトークンを追加します。
Metaのアカウントも、動画専用のグループも必要ありません。
仕組み
1
タスクを作成する
model と prompt を指定して、POST /v1/videos を呼びます。このエンドポイントは非同期で、動画の完成を待たずに、数秒でタスクの ID を返します。この ID を保存してください。2
状態をポーリングする
15秒おきに
GET /v1/videos/{id} を呼び、status を読み取ります。どの呼び出しもすぐに返ります。10秒までのクリップは通常2〜3分で完了し、混雑時は5分以上かかることがあります。20〜30秒のクリップは約4〜10分、40〜60秒のクリップは約5〜10分かかります。混雑時は60秒のクリップに20分近くかかることもあります。3
結果をダウンロードする
status が completed になったら、video_url からMP4をダウンロードします。ダウンロードに Authorization ヘッダーは不要です。準備
cURLの例では、レスポンスのフィールドを読み取るためにjq を使います(macOSでは brew install jq)。先にキーとベースURLを設定します。
動画を生成する
テキストから動画を生成する
seconds:省略すると、muse-videoは10秒のクリップを作ります。aspect_ratio:クリップの形。代わりに、720x1280のようなピクセル指定のsizeも送れます。先頭フレームや参照画像を送るときにも適用されます。詳しくは下の「画像を使うときのアスペクト比」を参照してください。
先頭フレーム、または先頭と末尾のフレームから動かす
image で最初のショットを指定し、last_frame を加えると最後のショットも指定できます。画像は、公開URLまたは data:image/...;base64, のデータURLで渡します。
input_reference、末尾フレームは last_frame に入れます。
-F でアップロードするときは、Content-Type: application/json を設定しないでください。画像は1枚あたり10 MBまでです。
参照画像から生成する
reference_images に、1〜4枚の画像を指定します。モデルは、画像の被写体とスタイルを動画に反映しますが、どの画像も先頭フレームとしては使いません。
画像を使うときのアスペクト比
先頭フレーム、末尾フレーム、参照画像を送るときは、クリップの形が次のように決まります。aspect_ratio(またはsize)を指定した場合: 生成の前に、各画像がその比率で中央トリミングされ、クリップもその形で出力されます。サイズは「リクエストのフィールド」にまとめています。- 指定しない場合: クリップは画像そのままの形になります。たとえば3:2の横向き写真なら、1152×768です。
20秒・30秒から最大60秒のクリップを作る
長いモデルは、いずれもモデル名のとおりの長さで、1本の連続したクリップを生成します(20〜60秒。料金は「料金」を参照)。呼び出し方はmuse-video と同じで、seconds は省略できます。
長いクリップは10秒ずつ生成してつなぎ合わせるため、つなぎ目ごとに動きが遅くなってから再び動き出し、一瞬止まったように見えることがあります。
流れを途切れさせたくないショットは、muse-video で10秒以内の1本として作ってください。それより長いクリップの扱い方は、よくある質問の「長いクリップの継ぎ目に演出は入りますか?」を参照してください。
60秒より長い動画や、手元のクリップの続きが必要な場合は、下の「60秒を超える動画を作る」を参照してください。
60秒を超える動画を作る
1つのタスクで作れるのは60秒までです。それより長い動画は、パートに分けて生成します。各パートは前のパートの最後のフレームから始め、最後にすべてを連結します。既存の動画の続きを作るときは、その動画を1本目のパートとして扱います。 次のスクリプトは、パートを順番に生成してから連結します。requests と ffmpeg が必要です。PROMPTS にパートごとのプロンプトを1つずつ書きます。手元の動画の続きを作るときは、START_VIDEO にそのローカルのパスを指定します。
muse-video-60s のパートを3本つなぐと、約3分の動画になり、料金は3 × $1.55 = $4.65です。各パートは通常のタスクで、そのモデルの料金で課金されます。途中のパートが失敗した場合、返金されるのはそのパートだけです。ダウンロード済みのパートはそのまま使えるので、失敗したパートから再開してください。
Pythonを使わない場合は、同じ手順を手作業で行います。
-
前のパートの最後のフレームを取り出します。
-
last-frame.jpgを先頭フレーム(image、multipartではinput_reference)にして、次のパートを作成します。送り方は「先頭フレーム、または先頭と末尾のフレームから動かす」を参照してください。 -
2つのパートを連結します。画像を使うと出力サイズが数十ピクセル異なることがあるため、新しいパートを1本目のサイズに合わせます(下の例は1280×720。実際のサイズに置き換えてください)。
- 各パートは前のパートの最後のフレームから始まるため、つなぎ目で画面がそろいます。
- 動きとBGMはパートごとに始まり直します。自然につなげるには、各プロンプトに次に起きることを書き、すべてのパートでアスペクト比と画風の設定をそろえてください。
画風とカメラワークを指定する
Museには7種類の組み込み画風と、13種類のカメラワーク・トランジションの技法があり、IDで選べます。画風やカメラの動きを自分の言葉で書くこともできます。どのMuseモデルでも使え、追加料金はかかりません。custom_style と custom_skill は単独でも、組み込みIDと重ねても使えます。次のリクエストは、アニメ調の画風にしたうえで、カメラの動きを文章で指定しています。
上のリクエストの出力:muse-video、10秒、16:9、style_preset 2d_anime と custom_skill
これらのフィールドを省略した場合の動作です。
style_presetを省略すると、組み込みの画風は加わらず、プロンプトと画像で画風が決まります。noneを指定しても同じです。skill_presetを省略すると、組み込みのトランジションは加わりません。長いクリップの各区間はそのまま続きますが、つなぎ目ごとに動きが遅くなってから再び動き出すことがあります。noneを指定しても同じです。occlusion_wipeを使うと、継ぎ目ごとに前景の物体が画面を覆い、1〜2秒ほど暗くなります。はっきり場面を区切りたいときだけ使ってください。noneはほかの技法と同時に指定できません。- 従来の
styleフィールドも、画風の自由記述のヒントとして引き続き使えます。
ポーリングとダウンロード
タスクを取得する
status が in_progress になり、progress におおよその進捗が百分率で入ります。
video_url が入ります。
status: "failed" になり、理由が error.message に入ります。課金はすでに返金されています。
動画をダウンロードする
Authorization ヘッダーを付けて GET /v1/videos/{id}/content を呼ぶと、MP4ファイルが返ります。
最小のPythonクライアント
requests が必要です(pip install requests)。
APIリファレンス
リクエストのフィールド
アスペクト比ごとの出力サイズです。
画像を使う場合は、同じ比率でも、この表より数十ピクセルほど異なるサイズになることがあります。たとえば16:9で1248×704、4:3で1056×800などです。フレームレートは常に24 fpsで、
resolution や fps を指定しても出力は変わりません。
タスクの状態
エラー
これらのエラーで料金はかかりません。
- 最初の6つは、送信時にHTTP 400として返り、タスクは作成されません。
Task protocol request failedとCurrent group … has no available channels …も送信時に返り、タスクは作成されません。- 残りは失敗したタスクとして届いて自動で返金されるか、メッセージに
This request is not charged.と書かれています。
よくある質問
5秒と10秒の料金は同じですか?
はい。muse-video は、5、8、10秒のいずれも$0.30です。さらに長い連続ショットには、muse-video-20s($0.55)、muse-video-30s($0.80)から、muse-video-60s($1.55)までを使います。
1080pの動画は作れますか?
いいえ。Museの出力は、横向きが1280×720、縦向きが720×1280です。そのほかの形は「リクエストのフィールド」にあります。resolution: "1080p" を送ってもエラーにはなりませんが、出力サイズは変わりません。
クリップが画像と同じ形になるのはなぜ?
aspect_ratio も size も指定しないと、Museは送った画像の形を維持します。aspect_ratio を加えると、画像が先にその比率で中央トリミングされ、希望の形のクリップが出力されます。切り取られた部分にいる人物は、クリップに登場しないことがあります。
被写体が画像の端に寄っているときは、アップロードの前に自分でトリミングしてください。詳しくは「画像を使うときのアスペクト比」を参照してください。
クリップの人物の顔が参照画像と違うのはなぜ?
Museは参照画像の人物の服装、髪型、全体のスタイルを引き継ぎますが、同じ顔になるとは限らず、すべての人物が登場するとも限りません。複数の人物がいる場面では、参照画像にいない人物が加わることもあります。元の画像、余白を足した画像、顔のアップのどれを送っても結果は同じでした。- プロンプトに各人物の外見と位置を書き、場面にいるのはこの人物たちだけだと明記してください。
aspect_ratioを指定すると、参照画像は先に中央トリミングされるため、端にいる人物が切れることがあります。アップロードの前に、全員が収まるように目的の比率へ自分でトリミングしてください。
動画に音声は付きますか? オフにできますか?
どのクリップにも音声が付き、BGMと効果音はプロンプトに沿って作られます。オフにするオプションはありません。音声が不要なときは、ダウンロードしたあとで音声トラックを取り除いてください。長いクリップの継ぎ目に演出は入りますか?
標準ではトランジションの演出は入りません。ただし、20〜60秒のクリップは10秒ずつのパートをつなぎ合わせて作られます。つなぎ目(10秒、20秒、30秒……)では、前のパートの終わりで動きが遅くなり、次のパートで再び動き出すため、一瞬止まったように見えることがあります。ネットワークやエンコードとは関係ありません。- 流れを途切れさせたくないショット:
muse-videoで10秒以内の1本として作ります。1本のクリップにはつなぎ目がありません。 - 20秒以上のクリップ:つなぎ目をカットとしてプロンプトに書きます(例:「10秒の時点で、もう一人の人物のアップに切り替える」)。または
skill_preset: "cut_on_action"か"whip_pan"を指定すると、各つなぎ目が通常の編集点になります。IDは上の「画風とカメラワークを指定する」にあります。
中国語のセリフの発音が不自然なのはなぜ?
Museはプロンプトに書いた中国語のセリフを人物に話させることができますが、中国語の発音は正確ではなく、毎回誤って発音される単語があります。これはモデルの制限です。中国語のセリフが重要な場合は、次のどちらかにしてください。- Gemini Omni 1.2 Flashを使います。同じ
/v1/videosエンドポイントで呼び出せ、プロンプトの中国語のセリフを正確に話します。720pで3〜10秒のクリップが1本$0.30です。 - Museを使い続ける場合は、動作と口の動きだけをプロンプトに書き、音声はあとで自分で吹き替えます。
60秒より長い動画は作れますか?
はい。1つのタスクで作れるのは60秒までなので、長い動画はパートに分けて生成します。各パートを前のパートの最後のフレームから始め、最後に連結してください。muse-video-60s のパートを3本つなぐと、約3分の動画が$4.65で作れます。スクリプトと手作業の手順は「60秒を超える動画を作る」にあります。
手元の動画を延長できますか?
はい。その動画を1本目のパートとして扱います。最後のフレームを次のパートの先頭フレームにして生成し、2本を連結してください。各パートは、そのモデルの料金で課金されます。スクリプトと手作業の手順は「60秒を超える動画を作る」にあります。タイムアウト後に再送してよいですか?
先にタスクを確認してください。クライアント側のタイムアウトは、タスクの失敗を意味しません。同じid のポーリングを続けてください。再送すると新しいタスクが作成され、再び課金されます。
status が failed のときだけ、リクエストを修正して新しいタスクを作成します。失敗したタスクはすでに返金されており、60分たっても完了していないタスクは、自動的に失敗として扱われて返金されます。
動画のリンクはいつまで保存されますか?
7日間です。その後はリンクの有効期限が切れ、タスクを再ダウンロードできなくなります。タスクが完了したらすぐにファイルを保存してください。関連ドキュメント
- 動画APIの比較と料金
- MiniMax H3動画API
- Seedance 2.0動画API
- Wan 2.7・Wan 3.0動画API
- モデルと料金
- 使用ログ
- Meta Model APIのモデル:Muse Spark、Muse Imageなど。動画生成モデルはありません(2026年10月30日確認)