

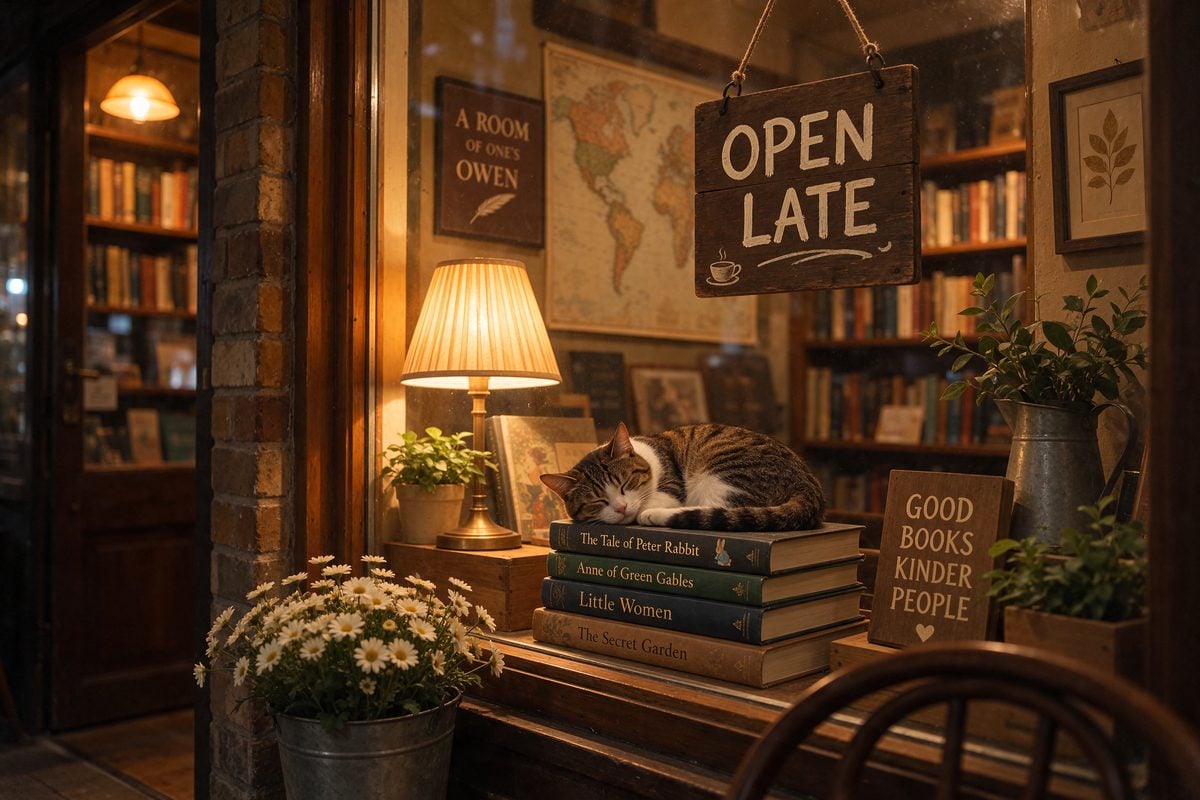
テキストからの生成の出力(2K、2496×1664):夜の書店のショーウィンドウ、本の上で眠る猫と「OPEN LATE」の手書き看板
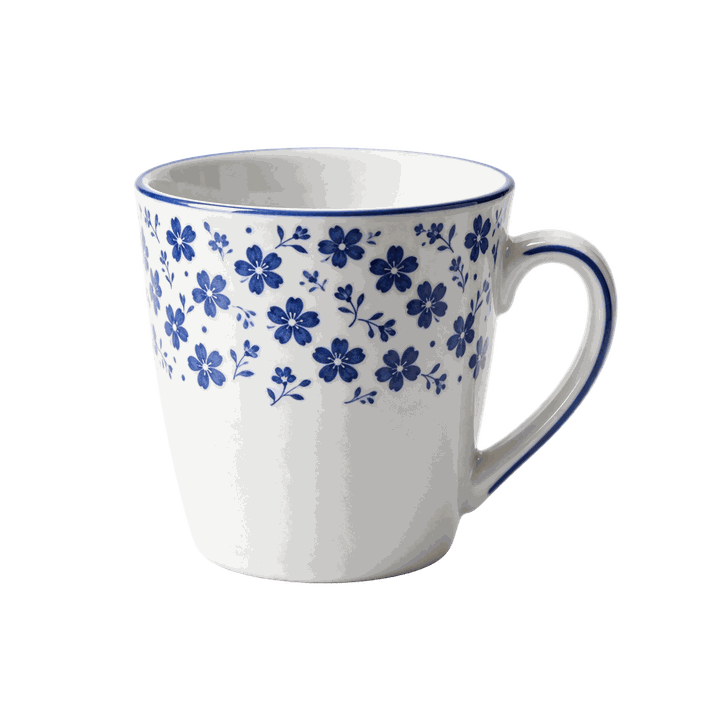
透過PNGの出力(1K、1024×1024、RGBA):青い小花柄の陶器のマグカップ
Seedream 5.0との違い
使い分けの目安です。
- 透過素材、細かいレイヤー、ポスターの文字の認識:Seedream 5.5
- 低コストで大量に生成:Seedream 5.0 Flash
- 3K・4K出力、連続生成(組画像):Seedream 5.0、4.5、4.0(Seedreamのサイズとバージョン)
呼び出しの準備
1
2
環境を準備する
キーを環境変数に設定し、Pythonの例で使うパッケージをインストールします。
3
保存スクリプトを用意する
cURLの例はレスポンスをJSONファイルに書き出します。次のスクリプトを
save_seedream.py として保存すると、data[] の画像をすべて、返された output_format の拡張子で保存できます。save_seedream.py
テキストから画像を生成する
上の書店の画像を出力したリクエストです。size は 2K で、ウォーターマークは付けません。
2K の結果は通常25〜35秒で返り、この例では2496×1664の画像が保存されます。2K などの解像度を指定した場合、アスペクト比は内容に合わせてモデルが決めます。比率を固定したいときは、2048x2048 や 2848x1600 のようにピクセル数で指定してください。
Pythonで生成する
透過PNGを生成する
background を transparent、output_format を png にすると、アルファチャンネル付きのRGBA画像が返ります。上のマグカップの画像はこのリクエストの出力です。
RGBA と表示すれば透過画像です。レスポンスの data[].background も transparent になります。
background に指定できる値は次の3つです。生成と編集のどちらでも使えます。
レイヤー分解のリクエストには
background を付けないでください。一緒に送るとエラーになります。
複数の参照画像で編集する
参照画像はimage に指定します。1枚なら文字列、複数なら最大10枚の配列です。各要素は公開URLか、data:image/png;base64,... 形式のデータURLです(形式名は小文字)。配列の順に「image 1」「image 2」と番号が付くので、プロンプトでその番号を使って指示できます。
ローカルの2つのファイルをデータURLとして送る例です。
画像をレイヤーに分解する
完成した1枚の画像を、背景と要素ごとの透過PNGレイヤーに分けます。リクエストの条件は次のとおりです。layer_decompositionをtrueにする。imageは1枚だけ。PNGかJPEGで、総ピクセル数が512×512以上、30 MB以下。backgroundは付けない。- 返す枚数の上限を
layer_decomposition_options.max_imagesで指定する(背景を含めて2〜100、既定値は30)。 - フォントや色も知りたいときは
layer_decomposition_options.text_recognitionをtrueにする。
1K でも20〜30秒ほどかかり、2K はさらに遅くなるため、クライアントのタイムアウトは300秒以上にしてください。
data[] は次の順に並びます。
- 先頭は背景です。
z_indexが0で、backgroundはopaqueです。 - 残りは要素1つずつの透過PNGです。位置を表す
bounding_box(absoluteとnormalized)が付きます。 - 各レイヤーには、モデルが付けた英語の
nameとdescriptionも入ります。
文字のスタイルを読み取る
text_recognition を true にすると、通常の文字のレイヤーに text_recognition が加わります。ポスターの「SUMMER」の文字を分解したときのレイヤーです(一部省略)。
装飾文字(アート文字)や手書き文字には
text_recognition が付きません。
この例でも、レイヤーのPNGは836×336のボックスに対して1616×649です。レイヤーのピクセルサイズはボックスと一致するとは限らないため、組み立て直すときは各レイヤーを absolute のボックスに合わせて拡大・縮小してください。各フィールドの意味とPillowで組み立て直すスクリプトは、レイヤーのレスポンスを読むにあります。
パラメーター
size をピクセル数で指定するときの条件です。
- 幅と高さの間は英字の
x(例:2048x2048、2848x1600)。乗算記号×は使えません。 - 総ピクセル数は921,600(
1280x720)〜4,624,220。 - アスペクト比は1/16〜16。
3Kと4Kはありません。
sequential_image_generation)、ストリーミング(stream)、Web検索に対応していません。これらのフィールドはリクエストに含めないでください。
料金
出力画像の枚数と参照画像の枚数で決まります。1K、1.5K、2K のどれでも同じ料金です。
- 出力画像1枚につき$0.035、参照画像1枚ごとに$0.008(1枚目も含む)を加算します。
- 200以外のレスポンス(パラメーターエラー、モデレーションによるブロック)は課金されません。
- 実際の課金額は呼び出しログで確認できます。
よくある質問
Seedream 5.5のモデルIDは?
seedream-5-5-261028 です。BytePlusでの名前 dola-seedream-5-5-261028 もそのまま使え、料金は同じです。どちらで呼び出しても、レスポンスの model には dola-seedream-5-5-261028 が入ります。
Seedream 5.5 APIは1枚いくらですか?
出力画像1枚$0.035です。1K、1.5K、2K で料金は変わりません。参照画像を使う場合は1枚ごとに$0.008が加わり、具体例は料金の表にあります。最新の価格はAIモデルのAPI料金一覧で確認できます。
fastモードは使えますか?
使えません。Seedream 5.5のoptimize_prompt_options.mode は standard だけです。
fast を送るとHTTP 400が返り、メッセージに must be standard for Seedream 5.5 が含まれます。このリクエストは課金されません。Seedreamで fast を使えるのは5.0 Proと4.0だけです。
Seedream 5.5で4K画像は出せますか?
出せません。最大は総ピクセル数4,624,220(2048x2048 程度)で、3K と 4K は指定できません。より大きい画像には別のバージョンを使います。
- 4K:
seedream-4-5-251128またはseedream-4-0-250828 - 3K:
seedream-5-0-260128
1回のリクエストで複数枚を生成できますか?
レイヤー分解を除き、1回のリクエストで返る画像は1枚です。Seedream 5.5は連続生成(sequential_image_generation)に対応していないため、複数枚が必要ならリクエストを複数回送ってください。関連する画像をまとめて生成する連続生成は、Seedream 5.0、4.5、4.0で使えます。
BytePlusのアカウントは必要ですか?
不要です。LaoZhang APIのdefault グループのキーだけで呼び出せます。課金方式は従量優先(推奨)か回数課金を選んでください。
結果のURLはいつまで有効ですか?
BytePlusによると、画像のURLは24時間有効です。受け取ったらすぐにダウンロードしてください。レスポンス内で画像を受け取りたいときは、response_format を b64_json にします。save_seedream.py はどちらの形式も保存できます。
関連ドキュメント
- Seedream API:Seedream 5.0 Flash、5.0 Pro、5.0、4.5、4.0の使い方と料金
- 画像APIの比較:Seedreamとほかの画像モデルの選び方
- Images API:共通のリクエストとレスポンスの形式
- AIモデルのAPI料金一覧:現在の価格とグループ
- 呼び出しログ:リクエストごとのモデルと課金額の確認
参考資料
- BytePlus ModelArk 画像生成API:リクエストパラメーター、
sizeの範囲、background、レイヤー分解(2026年11月13日確認) - BytePlus ModelArk モデル一覧:Seedream 5.5のモデル名